Est-ce que mes données servent à entraîner le modèle ?
Cette question revient systématiquement dès que l’on parle d’intelligence artificielle : mes données servent-elles à entraîner le modèle ?
La réponse est souvent : ça dépend.
Mais cela dépend moins du modèle utilisé que de la manière dont vous y accédez.
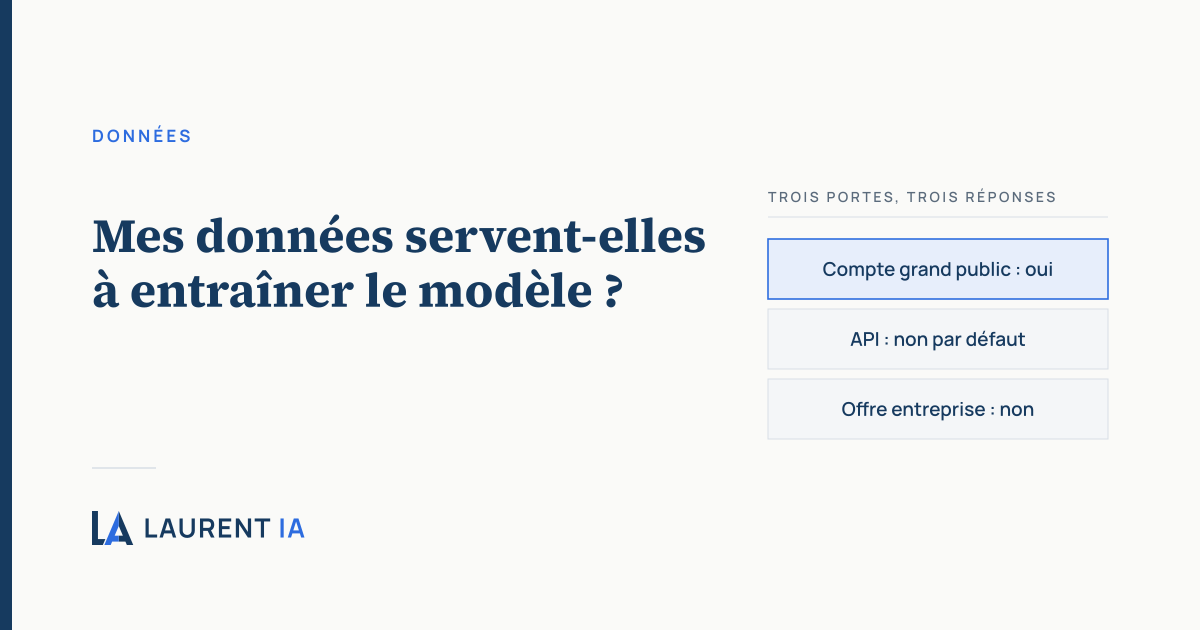
Les trois portes
En réalité, ce n’est pas le modèle utilisé qui fait la différence. Ce qui compte est surtout la porte d’entrée.
Les trois portes d’entrée de vos données
| Type d’accès | Utilisation pour l’entraînement | Point de vigilance / Nuances importantes |
|---|---|---|
| Compte grand public (gratuit / perso / Plus / Pro / Max) | Oui par défaut | OpenAI : Oui par défautAnthropic : Oui par défaut. Un écran de choix a été présenté lors du changement de politique, mais beaucoup ont laissé l’option activée sans y prêter attention. Réglage désactivable dans les paramètres de confidentialité.Mistral : Oui par défaut sur Free/Pro → désactivation possiblexAI (Grok) : Oui par défaut |
| API / Accès développeur | Non par défaut | C’est le point le plus méconnu des entreprises. Les données envoyées via l’API ne sont généralement pas utilisées pour entraîner les modèles publics (sauf cas explicite rare). Valable chez OpenAI, Anthropic, Mistral et xAI. |
| Offre Entreprise / Business / Team | Non (engagement contractuel) | Engagement écrit dans les conditions ou le DPA. À vérifier systématiquement avant signature. Chez Anthropic et Mistral, c’est particulièrement strict. |
Mais que veut dire « ne pas entraîner » alors ?
Quand une entreprise dit que les données ne sont pas utilisées pour l’entraînement, la signification est plutôt simple : vos conversations (prompts et réponses) ne seront pas injectées dans les prochains cycles d’entraînement ou de fine-tuning des modèles publics.
Autrement dit, elles ne serviront pas à faire évoluer les modèles (les connaissances et le comportement général de l’IA) et ne seront pas utilisées pour créer les prochaines versions.
À noter : certaines politiques prévoient des exceptions à ces réglages, par exemple pour des revues de sécurité.
Ce que ça ne veut pas dire
| Ce que les gens croient souvent | La réalité |
|---|---|
| L’entreprise ne stocke pas du tout mes données | Faux. Elles peuvent être conservées pendant une durée limitée pour des raisons de sécurité, de débogage ou de conformité. (30 jours, plusieurs mois, parfois plus). |
| Personne ne lit jamais mes conversations | Faux. Des humains ou des systèmes de sécurité peuvent les examiner (abus, sécurité, conformité légale). |
| Le modèle n’apprend rien de mon interaction | Partiellement vrai. Le modèle n’apprend pas « en direct », mais l’entreprise peut quand même analyser les interactions pour améliorer le produit (sans forcément entraîner le modèle). |
| Mes anciennes données sont effacées du modèle | En pratique, non. Une fois qu’une donnée a servi à entraîner un modèle, elle est intégrée dans ses poids. Des travaux de recherche existent (machine unlearning), mais ils ne sont pas utilisés aujourd’hui dans les modèles commerciaux. |
| Zéro rétention de données | C’est une autre chose (Zero Data Retention). On peut ne pas entraîner et garder les données un certain temps. |
Ce que ça change dans votre entreprise
Il y a trois réflexes à avoir :
- Identifier la porte réellement utilisée par les collaborateurs. Beaucoup utilisent leur compte personnel ChatGPT ou Claude sans que l’entreprise en ait conscience
- Vérifier la notion de non-entraînement avant de signer un contrat avec un fournisseur d’IA. Est-ce que les données peuvent être utilisées pour entraîner les modèles publics ? Exiger une réponse claire et écrite dans le contrat
- Garder les données sensibles vraiment hors de tout ça. Le risque de fuites de données via une erreur humaine, un bug ou autre est réel. Et une fois que les données sont sorties, il est trop tard
Conclusion
Lorsqu’une entreprise évalue une solution d’IA, la première question ne devrait donc pas être :
“Quel modèle utilisez-vous ?”
En matière d’IA, la confidentialité des données dépend davantage des conditions d’utilisation que du modèle lui-même. La bonne question est plutôt :
“Comment nos données sont-elles traitées, et qu’est-ce qui est écrit dans le contrat ?”
Pour aller plus loin
Si ce sujet vous intéresse, j’aborde plus en détail les risques liés au Shadow IA et les différences entre IA locale et IA cloud dans deux autres articles du site :
Shadow IA : https://laurent-ia.fr/shadow-ia/
IA Cloud ou IA locale : https://laurent-ia.fr/ia-locale-vs-ia-cloud/
Ils reprennent plus en détail les risques et réflexes à avoir en entreprise et quelles solutions sont possibles.